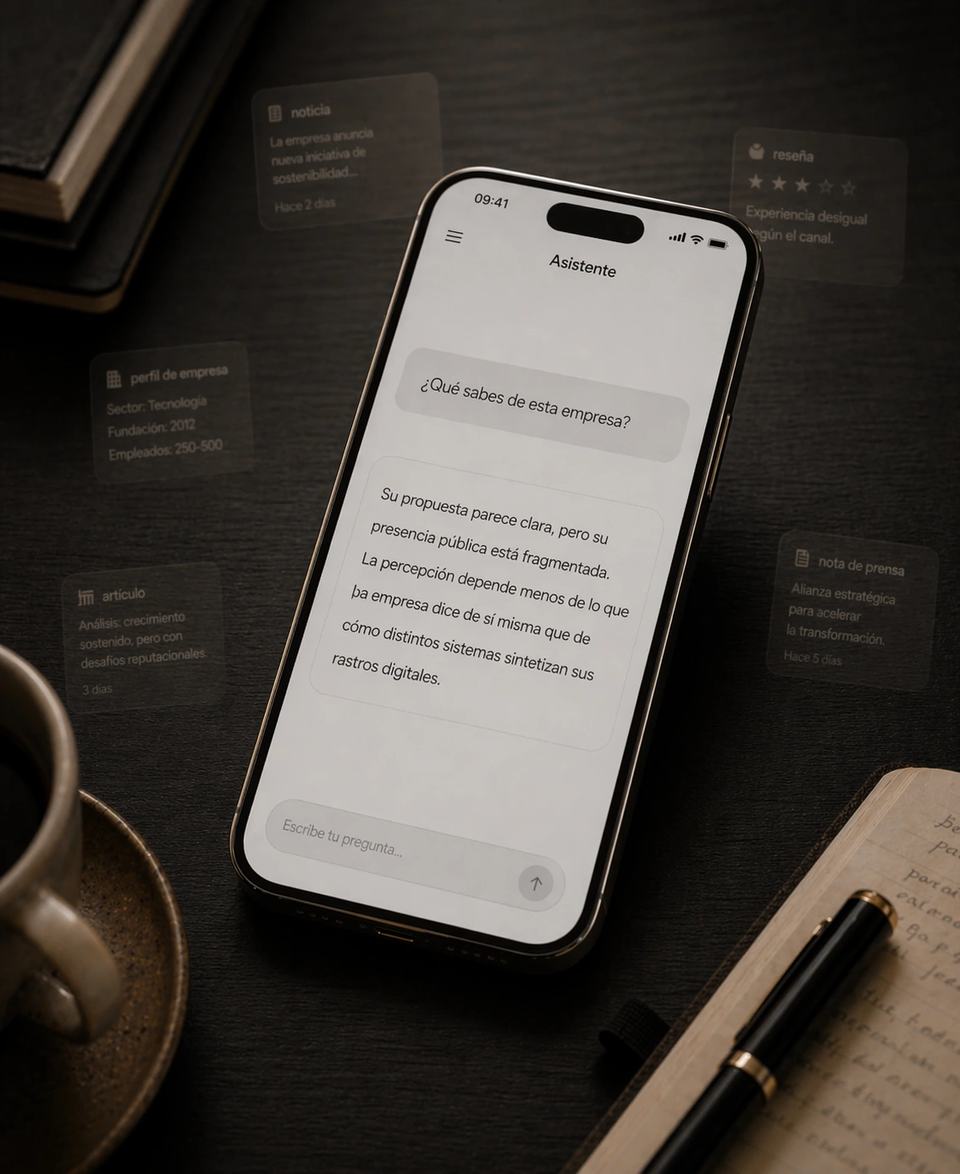
Imagina esto.
Un inversor, un cliente potencial, un periodista o alguien a quien quieres contratar abre el móvil al comenzar su jornada y teclea una pregunta muy sencilla:
«¿Qué sabes de esta empresa?»
No entra en tu web.
No lee tu dosier corporativo.
No ve la campaña que con tanto mimo desplegaste.
A los pocos segundos aparece un párrafo limpio, ordenado y seguro de sí mismo. Una síntesis breve de lo que la máquina cree saber sobre ti. Quizá acierte con tu actividad principal. Quizá te reduzca a una categoría gris. Quizá rescate una noticia antigua, una reseña lateral, una descripción incompleta o una comparación incómoda.
O quizá ni siquiera te mencione.
Y ahí ocurre algo que muchas organizaciones todavía no han entendido del todo: la primera impresión ya no depende solo de lo que tú dices de ti. Depende también de lo que los sistemas son capaces de sintetizar sobre ti.
Google sigue dominando la búsqueda tradicional. En España, conservaba el 91,91 % de cuota de mercado en marzo de 2026, según Statcounter. Pero el asunto no es que Google se esté diluyendo o vaya a desaparecer. Lo relevante es que Google está llevando la lógica de la inteligencia artificial al interior de sus propias superficies: el buscador, Chrome, Gmail, Calendar, YouTube, Maps. Todo empieza a comportarse menos como una colección de herramientas separadas y más como un entorno asistido por modelos.
La última evolución de Chrome lo muestra con bastante claridad. Gemini ya no es solo una aplicación a la que uno acude para preguntar algo. Se integra en el navegador, trabaja con el contexto de las pestañas abiertas, resume, compara, aclara y acompaña la navegación sin obligarte a salir de la página.
La IA deja de ser un destino. Empieza a estar ahí, donde todo empieza.
No estamos pasando simplemente de «buscar en Google» a «preguntar a ChatGPT». Estamos pasando de una web organizada alrededor de enlaces a una experiencia organizada alrededor de respuestas, resúmenes, asistentes y acciones sugeridas. La pregunta ya no es solo qué posición ocupa tu marca en un resultado de búsqueda. Es cómo aparece —o desaparece— cuando esa búsqueda se convierte en una síntesis.
Durante años, la reputación digital se entendió como una mezcla de posicionamiento en Google, presencia en medios, reseñas, redes sociales, tráfico, menciones y control razonable de los activos propios. Era un ecosistema imperfecto, pero visible. Podías buscar tu nombre, revisar resultados, detectar problemas, optimizar páginas, empujar contenidos, medir clics.
Ahora aparece una capa distinta.
La podríamos llamar reputación algorítmica: la imagen que una máquina reconstruye sobre ti cuando convierte rastros dispersos en una respuesta aparentemente coherente.
No es exactamente reputación online. No es exactamente SEO. No es exactamente marca.
Es otra cosa.
Los modelos no opinan como una persona. No tienen criterio propio en el sentido humano de la palabra. Pero sí producen una apariencia de criterio. Seleccionan, jerarquizan, comparan, omiten y enfatizan. Y para quien recibe la respuesta, esa diferencia filosófica importa menos de lo que nos gustaría admitir.
Si el resumen parece fiable, opera como reputación.
Ahí entra el famoso «problema del 30 %».
Según el informe The 2026 State of AI Search, de AirOps, solo alrededor del 30 % de las marcas que aparecen en una respuesta generada por IA vuelve a aparecer en la siguiente respuesta a la misma consulta. Si la pregunta se repite cinco veces, la persistencia baja al 20 %.
Pero el dato más revelador no es solo ese.
Más de la mitad de las marcas que desaparecen vuelve a aparecer una o dos respuestas después. Es decir: tu marca no ocupa una posición. Entra y sale del relato. Aparece, se diluye, reaparece, queda sustituida por otra, vuelve a ser citada. No porque alguien haya decidido expulsarla, sino porque el sistema reconstruye la respuesta cada vez.
Y aquí es donde la pregunta cambia radicalmente.
Ya no basta con decir: «¿Estoy bien posicionado?»
La pregunta correcta es más incómoda:
«¿Tengo suficientes señales claras, recientes y fiables para que los modelos me recuperen bien una y otra vez?»
Porque ya no basta con estar. Hay que persistir.
En la búsqueda tradicional todavía existía una cierta ilusión de estabilidad. Había una primera página, una segunda, una tercera. Había posiciones. Había caídas visibles. En la búsqueda generativa, en cambio, no hay una «posición siete» esperando a que alguien haga scroll. Hay una respuesta breve, unas pocas fuentes y una decisión implícita sobre quién merece estar dentro del relato.
Y quien no entra en ese relato, no queda más abajo.
Queda fuera.
El problema ya no es solo aparecer. Es reaparecer. Y reaparecer bien.
Ahí está el verdadero problema del 30 %: la visibilidad algorítmica es inestable, pero la percepción que produce puede ser tremendamente estable en la cabeza de quien lee. El sistema duda, rota y recompone. El usuario, en cambio, recibe un párrafo con apariencia de autoridad y se queda con una impresión.
No basta, por tanto, con tener una página propia bien escrita. El modelo necesita señales redundantes: contenido claro, menciones externas, fuentes creíbles, páginas actualizadas, estructura fácil de interpretar.
La reputación algorítmica se parece menos a una campaña y más a una red de señales. Algunas propias. Muchas ajenas. Todas susceptibles de ser sintetizadas.
Y esa red, en muchos casos, está descuidada.
Una empresa puede tener una web impecable y seguir siendo débil ante la IA si nadie relevante habla de ella, si sus casos de estudio son vagos, si sus páginas no responden a preguntas reales, si su presencia externa está fragmentada o si sus activos públicos no explican con claridad qué hace, para quién lo hace y por qué debería importar.
El modelo no entiende tu marca como la entiende un buen director de comunicación. La reconstruye a partir de rastros.
Y si los rastros son pobres, antiguos o contradictorios, la síntesis también lo será.
Por eso es tan incómodo otro hallazgo del informe: alrededor del 85 % de las menciones de marca en respuestas de IA procede de páginas de terceros, no de dominios propios.
Tu web sigue importando, pero ya no basta.
Tu reputación se forma también en el ecosistema que habla de ti cuando tú no estás presente.
Esto obliga a corregir una tentación bastante comprensible: pensar que la respuesta consiste en escribir para robots.
No.
La reputación algorítmica no se gestiona llenando internet de textos optimizados con entusiasmo de becario ansioso. Se gestiona haciendo que tu presencia pública sea más clara, más verificable, más consistente y más difícil de malinterpretar.
No se trata de producir más contenido. Se trata de construir mejores señales de autoridad.
Hay un protocolo mínimo que cualquier directivo, fundador o responsable de comunicación debería aplicar ya.
Primero: diagnóstico.
Abre ChatGPT, Claude, Gemini, Perplexity y Google, y lanza preguntas naturales, como las que haría un cliente de verdad: «¿Qué sabes de esta empresa?», «¿Por qué debería contratarla?», «¿Qué riesgos o críticas existen sobre esta marca?», «¿Qué alternativas hay?», «¿Qué diferencia a esta persona o proyecto de otros similares?».
No una vez. Varias. Con pequeñas variaciones. El objetivo no es encontrar una verdad revelada. Es detectar patrones.
Ejemplo real: al preguntar a Google qué puede decir sobre Fast Forward Communication, la respuesta sintetiza la actividad de la agencia a partir de varias fuentes públicas. La descripción es razonablemente acertada, pero también muestra por qué conviene auditar estas respuestas: la IA selecciona, ordena y, a veces, mezcla señales que no siempre controlas.

Segundo: consistencia.
Mira qué se repite. Qué desaparece. Qué se exagera. Qué falta. Qué aparece sin que tú lo hayas promovido. Qué prueba no está siendo recogida. Qué palabras usa la máquina para describirte cuando tú no estás en la habitación.
Tercero: fuentes.
La auditoría útil no consiste solo en preguntar «qué dice la IA». Consiste en entender de dónde sale eso que dice: tu web, tus notas de prensa, tus biografías, tus casos de estudio, tus perfiles sociales, pero también medios, rankings, reseñas, entrevistas, bases de datos, comparativas y archivos antiguos.
A veces el problema no está en la respuesta. Está en el ecosistema que la respuesta condensa.
Cuarto: corrección.
La corrección no empieza manipulando modelos. Empieza haciendo mejor el trabajo que deberías haber hecho de todos modos: una web más clara, una propuesta más legible, casos de estudio más específicos, biografías consistentes, contenido propio con datos y criterio, presencia en fuentes externas fiables, páginas que respondan bien a las preguntas que un cliente real formularía.
La buena comunicación siempre ha consistido en reducir el margen de malentendido.
La IA solo ha encarecido el precio de no hacerlo.
Al final, toda auditoría algorítmica debería dejarte frente a tres preguntas bastante incómodas:
¿Mi narrativa es clara, consistente y difícil de malinterpretar por una máquina?
¿Qué parte de mi autoridad real no está siendo visible para la máquina?
¿Qué síntesis recibiría hoy alguien que está a punto de decidir si me llama, me compra, me financia, me entrevista o me descarta?
No son preguntas técnicas. Son preguntas de reputación y criterio. En definitiva: ¿qué se dice de ti cuando no estás?
La primera impresión no ha desaparecido. Solo ha cambiado de intermediario. Antes podía formarse en una portada, una conversación, una búsqueda en Google o una recomendación personal. Ahora también se forma en un párrafo generado en segundos por un sistema que no te conoce, pero habla de ti con una seguridad implacable.
Y esa falsa seguridad, precisamente, es el problema.
Si esta cuestión afecta a tu marca, empresa o equipo, hablemos. Podemos ayudarte a revisar cómo está siendo interpretada tu presencia pública por los sistemas de IA y qué señales conviene reforzar.
Porque la reputación, a partir de ahora, no solo se construye. También se interpreta por máquinas. Y conviene que esa interpretación no quede abandonada al azar.